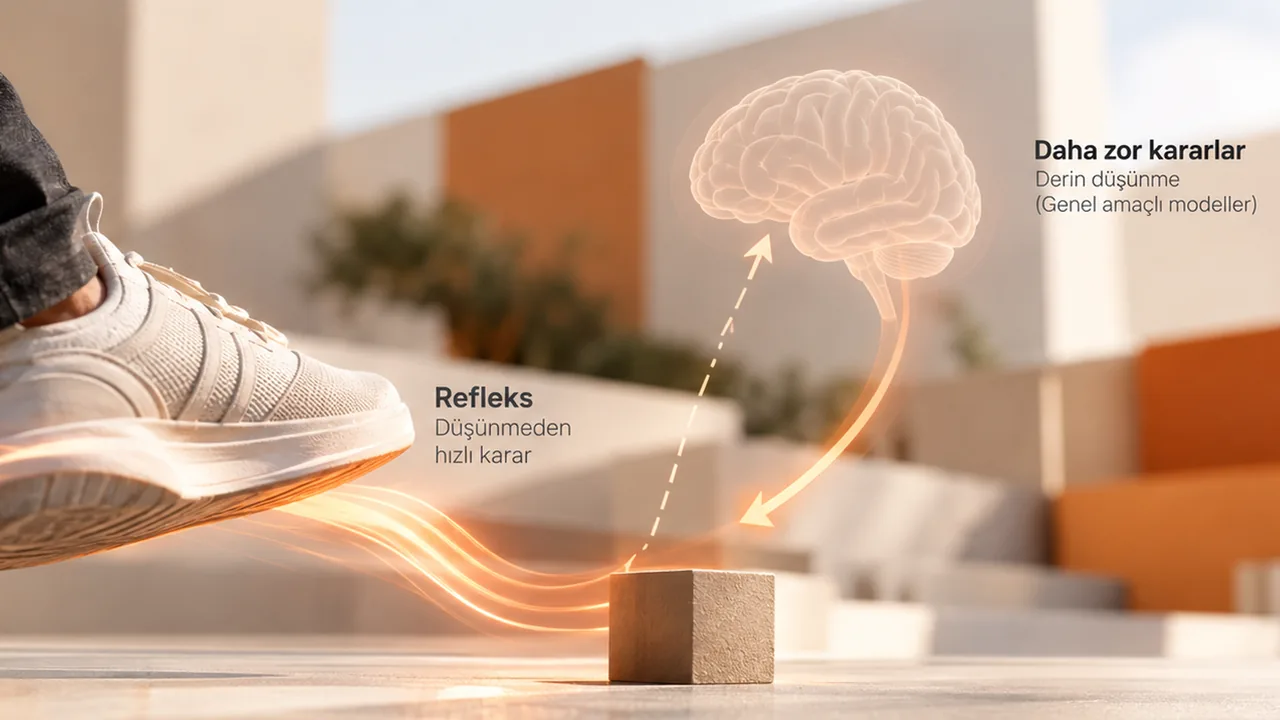
Elinizi sıcak bir yüzeye değdirdiğinizde önce uzun uzun düşünüp sonra çekmezsiniz. Vücut bazı tepkileri mümkün olduğu kadar kısa yoldan verir. Ben Jev için “refleks modeli” benzetmesini bu yüzden kullanıyorum. Bu biyolojik refleksin teknik karşılığı değil; modelin ne yapmaya çalıştığını anlatmak için kullandığım editoryal bir benzetme.
TypeSafe AI bu sınıfa “System One Model” adını veriyor. İsim, Daniel Kahneman’ın hızlı ve sezgisel Sistem 1 ile daha yavaş ve deliberatif Sistem 2 ayrımından geliyor. Şirketin 15 Eylül 2026’da duyurduğu ilk model Jev, sohbet etmek, uzun açıklamalar üretmek veya kod yazmak için tasarlanmamış. Bir durumu okuyup önceden tanımlanmış sorulara typed kararlar, olasılıklar ve güven değerleri döndürüyor.
Refleks modeli derken neyi kastediyorum?
Refleks modeli, bu yazıda açık uçlu metin üretmek yerine sınırları önceden tanımlanmış bir karar alanında çok hızlı semantik karar vermek için kullanılan modeli anlatıyor. Refleks ajan ise yapay zekâ literatüründeki ayrı bir ajan kavramı. İkisini birbirine karıştırmıyorum.
Kısaca
- Hızlı karar veren yapay zekâ yeni değil; spam filtreleri, risk modelleri ve classifier’lar bunu yıllardır yapıyor.
- Yeni olan, doğal dille tarif edilen daha karmaşık semantik kararları her seferinde genel amaçlı bir metin üretim modeline çevirmeden otomasyona sokma iddiası.
- Jev büyük dil modellerinin “küçüğü” değil. Farklı bir çıktı biçimi ve farklı bir yazılım rolü için tasarlanıyor.
Hızlı karar veren yapay zekâ zaten vardı
Burada tarih yazarken en kolay yapılacak hata, “eskiden yapay zekâ yavaştı, şimdi Jev geldi ve hızlandı” demek olur. Böyle bir şey yok. Spam filtreleri, kredi risk modelleri, sahtekârlık tespit sistemleri, sıralama modelleri ve klasik sınıflandırıcılar yıllardır milisaniyeler içinde karar verebiliyor.
Sorun hız değildi. Sorun, bu sistemlerin çoğunun hangi problemi çözeceğinin önceden çok daha sıkı tanımlanması gerekliliğiydi. Yeni bir karar problemi çoğu zaman yeni veri, etiketleme, özellik mühendisliği, fine-tuning veya ayrı bir model geliştirme işi çıkarıyordu. Bir spam filtresi hızlıydı; ama yarın ona doğal dille bambaşka bir operasyon sorusu sorup aynı rahatlıkla çalıştıramıyordunuz.
Ne değişti?
Değişen şey “hızlı karar” fikri değil. Büyük ön-eğitimli modeller, doğal dilde tarif edilen çok farklı görevleri aynı genel temsil üzerinden anlayabilmenin mümkün olduğunu gösterdi. Jev gibi yaklaşımların ilginç tarafı, bu semantik esnekliği tekrar hızlı ve yazılım-dostu karar katmanına taşımaya çalışmaları.
Bu noktaya nasıl geldik?
- 2018 — BERT: Büyük miktarda metin üzerinde önceden eğitilmiş tek bir dil temsilinin, çok farklı NLP görevlerine az mimari değişiklikle uyarlanabildiğini gösterdi. Yine de görev başına fine-tuning gerekiyordu.
- 2020 — GPT-3: Yeni görevlerin binlerce etiketli örnekle yeniden eğitilmesi yerine, görevin doğrudan metinle tarif edilip birkaç örnekle yapılabileceğini güçlü biçimde gösterdi.
- 2022 — InstructGPT: Talimat izleme ayrı bir araştırma ekseni hâline geldi. Jev’in kurucusu Diogo Almeida da bu çalışmanın yazarları arasındaydı.
- Yaklaşık 2024 — Şirketin kuruluşu: Almeida OpenAI’dan ayrılıp TypeSafe’ı kurdu. Şirket kendi anlatımına göre yaklaşık iki yıl boyunca gizli çalıştı.
- 15 Eylül 2026 — Jev: İlk “System One Model” olarak Jev duyuruldu; odak sohbetten doğrudan yazılım içindeki kararlara çevrildi.
Önce “makine bunu yapabilir mi?” sorusunu çözdük. Şimdi “bunu yapmak için gerçekten bu kadar makineye ihtiyacımız var mı?” diye soruyoruz.
Büyük dil modellerinin asıl kırılma noktası yalnızca daha iyi metin üretmeleri değildi. Bir sözleşmeyi, müşteri mesajını, log kaydını, destek talebini veya operasyon notunu aynı genel modelin anlayabilmesi, daha önce ayrı ayrı mühendislik gerektiren birçok görevi doğal dille tarif edilebilir hâle getirdi.
Bu yüzden bugün bir e-postayı sınıflandırmak için bile genel amaçlı bir LLM çağırabiliyoruz. “Şu mesajı oku ve faturalama, teknik destek veya satış seçeneklerinden yalnızca birini döndür” diyoruz. Structured Outputs gibi sistemler artık cevabın belirli bir şemaya uymasını da güvenilir biçimde sağlayabiliyor.
Ama burada ayrı bir mühendislik sorusu ortaya çıkıyor: İstediğimiz sonuç yalnızca bir karar ise neden her seferinde metin üretmek üzere optimize edilmiş bir sistemi çalıştırıyoruz? Jev’in iddiası esasen bu uyumsuzluğu hedefliyor.
Refleks dediğimiz şey iş hayatında neye benziyor?
01 · Müşteri itirazı gelir
Bir müşteri, kredi kartından aynı ödemenin iki kez çekildiğini yazıyor. Mesaj uzun, dağınık veya öfkeli olabilir. Jev gibi bir modelin işi burada müşteriye cevap yazmak değil; metnin içinden şirket için gerekli kararı çıkarmaktır.
02 · Sorunun türü anında ayrılır
Model mesajı okuyup bunu “mükerrer tahsilat şüphesi” olarak işaretler ve kararını yaklaşık 70–500 milisaniye içinde döndürür. Uzun bir metin üretmez; örneğin “ödeme sorunu / finans kontrolü” gibi yazılımın doğrudan kullanabileceği sınırlı bir sonuç verir.
03 · İş doğru masaya düşer
Sistem bu kararı kullanarak talebi otomatik biçimde finans veya muhasebe akışına gönderir; ilgili ödeme kaydı kontrol edilir ve gerekiyorsa işlem açılır. Buradaki kazanç, bir yapay zekânın güzel cevap vermesi değil; kararın doğrudan iş akışını tetiklemesidir.
04 · Emin değilse durur
Model yalnızca karar değil, ne kadar emin olduğunu da döndürebilir. Mesaj belirsizse veya güven düşükse otomatik işlem yapmak yerine dosya muhasebe ya da müşteri hizmetlerindeki yetkili kişiye gider. Yani hız kadar önemli olan şey, ne zaman karar vermemesi gerektiğini de sisteme anlatabilmesidir.
| Yaklaşım | Güçlü olduğu taraf | Yeni görev nasıl tanımlanır? | Çıktı |
|---|---|---|---|
| Klasik classifier | Çok hızlı, dar ve iyi tanımlı kararlar | Genellikle görev özel veri/eğitim/mühendislik ister | Sınıf, skor veya olasılık |
| Genel amaçlı LLM | Yeni ve açık uçlu görevleri doğal dille anlayabilme, üretim ve muhakeme | Prompt / talimat / örneklerle hızlıca değiştirilebilir | Metin; gerektiğinde yapılandırılmış çıktı |
| Jev / System One yaklaşımı | Doğal dille tarif edilen sınırlı semantik kararları yazılım içinde hızlı kullanma | State + instructions/criteria + typed questions; müşteri başına fine-tune yok | Typed karar + olasılık + güven |
Jev neden küçük bir LLM değil?
Kamuya açık dokümantasyon bu ayrımı oldukça net yapıyor. Jev’e bir state veriyorsunuz ve bu durum üzerinde typed sorular soruyorsunuz. Şu an üç temel soru biçimi var: Choice bir seçenek seçiyor, Score bir rubriğe göre puanlıyor, Noul ise bir önermenin ne kadar doğru olduğunu 0–1 arasında değerlendiriyor.
Modelin işi paragraf yazmak değil. Cevapları ve olasılık dağılımlarını doğrudan kodun kullanabileceği biçimde döndürüyor. Aynı state üzerindeki sorular paralel ve birbirinden bağımsız değerlendiriliyor. Kamuya açık dokümantasyona göre Jev müşteri verisiyle ayrı ayrı fine-tune veya LoRA yapılmıyor; aynı model ağırlıkları bütün hesaplara servis ediliyor. Alan bilgisi state, instructions ve criteria içinde veriliyor.
Jev’in yazılım içindeki temel rolü
- State — e-posta, işlem kaydı, log, ajan durumu veya başka metinsel bağlam.
- Typed soru — seçim, skor veya doğru/yanlış ekseninde sınırları önceden tanımlanmış soru.
- Karar + olasılık — serbest metin yerine kodun doğrudan tüketebileceği sonuç ve belirsizlik.
- Yazılım davranışı — kod branch eder, API çağırır, LLM çalıştırır, kaydı işaretler veya insana yollar.
Teknik sınır
TypeSafe yeni bir model mimarisi, paralel sampler ve Reinforcement Learning for Calibrated Decisions (RLCD) adını verdiği eğitim yönteminden söz ediyor. Ancak ayrıntılı ve bağımsız biçimde yeniden üretilebilir teknik açıklama henüz sınırlı. “System One Model” ifadesini bu aşamada yerleşmiş akademik kategori değil, TypeSafe’ın kendi model sınıfı tanımı olarak okumak daha doğru.
100 milisaniyenin farkı: karar artık akışın içine girebiliyor
Jev’in en dikkat çekici iddiası burada. Üreticinin kendi ölçümlerine göre uçtan uca gecikme yaklaşık 70–500 milisaniye, fiyat milyon giriş tokenı başına 0,042 dolar ve serbest metin üretilmediği için ayrı çıktı tokenı ücreti yok.
70–500 ms
Üreticinin açıkladığı uçtan uca gecikme aralığı
$0,042 / M
Milyon giriş tokenı için açıklanan fiyat
0
Ayrı çıktı tokenı ücreti
Bu rakamların önemi “bir chatbot biraz daha hızlı cevap verdi” düzeyinde değil. Bir karar her kullanıcı isteğinde, her ajan adımında, her tool call öncesinde, her güvenlik kontrolünde veya saniyede birçok kez verilecekse birkaç saniyelik model çağrısı sistem mimarisini değiştiriyor. Yüz milisaniyelik bir karar ise yazılımın normal kontrol döngüsünün içine girebiliyor.
Örnek: ajan hangi aracı çağırmalı?
Bir ajan onlarca araç arasından seçim yapacaksa önce uzun bir açıklama üretmesine gerek yok. “Bu işlem için CRM mi, ödeme sistemi mi, arama motoru mu, yoksa insan mı gerekli?” sorusu yüzlerce kez tekrarlanabilir. Burada amaç daha az akıllı bir cevap üretmek değil; cevap türünü doğrudan karar olarak tasarlamak.
Bir refleks tek başına sistem değildir
Burada daha önce yaptığım önemli bir anlatım hatasını düzeltmek gerekiyor. Klasik kod, Jev, büyük dil modeli ve insanı “artan zekâ katmanları” şeklinde üst üste koymak yanlış. Bunlar aynı işi farklı zekâ seviyelerinde yapan dört seçenek değil.
Kamuya açık routing örneğinde Jev önde duran hızlı bir karar bileşeni. Gelen talebin niyetini ve karmaşıklığını sınıflandırıyor. Sonra işi deterministik koda, uzman bir LLM’e veya insana yönlendirebiliyor. Güven yeterli değilse doğrudan insan devreye girebiliyor.
Hiyerarşi değil, orkestrasyon
- Girdi gelir — müşteri mesajı, alarm, işlem veya ajan durumu.
- Refleks kararı — niyet, risk, karmaşıklık veya başka sınırlı semantik özellikler hızla değerlendirilir.
- Uygun işleyici seçilir — klasik kod, veri tabanı/API, uzman LLM, başka model veya insan.
- Belirsizlik de akışın parçasıdır — düşük güven, otomatik karar vermek yerine başka bir işleyiciye yönlendirme nedeni olabilir.
Neden önemli?
Jev’in ismi William Stanley Jevons’tan geliyor. Şirketin ekonomik tezi şu: karar başına makine zekâsının maliyeti ciddi biçimde düşerse bugün ekonomik olmadığı için hiç AI çağrısı yapmadığımız çok sayıda küçük karar otomasyona girebilir. Burada Jevons paradoksu bir performans iddiası değil, şirketin ürün vizyonu.
Yanlış cevap verebilir; ama belirsizliği görünür kılmaya çalışıyor
Üreticinin “halüsinasyon yapamaz” ifadesini dikkatli okumak gerekiyor. Jev’in olası çıktıları önceden tanımlı olduğu için şemanın dışına çıkan dördüncü bir seçenek veya beklenmedik metin üretmemesi başka şey; doğru seçeneği seçmesi başka şey.
| Katman | Ne soruyoruz? | Jev için durum |
|---|---|---|
| Şema / type güvenliği | Çıktı tanımlı biçimin dışına çıkıyor mu? | Üretici bunu mimari garanti olarak sunuyor. |
| Karar doğruluğu | Model doğru seçeneği mi seçti? | Garanti değil; yanlış sınıflandırma hâlâ mümkün. |
| Kalibrasyon | %90 güven denilen kararlar uzun vadede gerçekten yaklaşık %90 doğru mu? | Ölçülmesi ve gerektiğinde yeniden kalibre edilmesi gerekiyor. |
İlk bağımsız uygulama verilerinden biri: trafik kazası anlatıları
Eylül 2026’da yayımlanan bir çalışma Jev’i Texas trafik kazası anlatılarını yapılandırılmış değişkenlere çevirmek için kullandı. Buradaki görev tam da Jev’in hedeflediği sınıfa benziyor: uzun ve dağınık doğal dili okuyup önceden tanımlanmış çok sayıda karara dönüştürmek.
499.500
Taranan anlatı
195.857
27 soruluk şemayla kodlanan kayıt
2.416
Kör insan değerlendirmesi
0,908 F1
İnsan etiketlerine karşı Jev sonucu
Çalışmada karşılaştırılan frontier modellerden biri yaklaşık 0,059 daha yüksek F1 verdi; diğerinin sonucu Jev’den anlamlı biçimde ayrılmadı. Daha ilginç taraf ise kalibrasyondu: araştırmacılar Jev’in olasılıklarının doğrudan kusursuz olmadığını ve aynı insan etiketleri üzerinde yeniden kalibrasyonun kalibrasyon hatasını 3,3 kat azalttığını buldu.
Buradaki asıl sonuç
Jev’in değeri “hiç hata yapmaması” değil. Asıl vaat, karar alanını sınırlamak, belirsizliği sayısallaştırmak ve hangi kararların otomatik uygulanabileceğini yazılım mimarisinin açık bir parçası hâline getirmek.
Yeni kategori mi, eski fikrin yeni biçimi mi?
Burada üreticinin anlattığı hikâyeyi olduğu gibi “daha önce kimse bunu düşünmemişti” diye almak da yanlış olur. Classification eski. Model routing eski. LLM’lerden yapılandırılmış veri çıkarmak eski. 2024’te OpenAI’nin Structured Outputs özelliği, üretici bir modelin geliştiricinin verdiği JSON Schema’ya güvenilir biçimde uymasını sağladı. Aynı yıl RouteLLM gibi çalışmalar da istekleri daha güçlü veya daha ucuz modellere yönlendiren hafif router modelleri araştırıyordu.
Dolayısıyla Jev’in yeniliğini tek tek parçaların ilk kez icat edilmesinde aramak doğru değil. Jev’deki asıl hamle, karar üretmeyi modelin merkezî işi hâline getirmek: metin üretimini bırakmak, paralel typed kararlar vermek, olasılık ve kalibrasyonu API sözleşmesinin parçası yapmak ve bütün ürünü “software-first” bir arayüz etrafında kurmak.
İlk açık ağırlıklı emsal
Jev’in duyurusundan kısa süre sonra Convai Innovations, Laya adlı açık kaynak/açık ağırlıklı, non-autoregressive “System 1 decision model” yayımladı. Laya da state + typed questions yaklaşımını kullanıyor ve classification, routing, scoring ve guardrail gibi görevleri hedefliyor. Bu tek başına yeni bir sektörün doğduğunu kanıtlamaz; fakat fikir ve arayüzün tek bir kapalı ürüne mahkûm olmadığını gösteren erken bir işaret.
- Karar doğruluğu. Model tanımlanan seçenekler arasında doğru kararı ne kadar sık veriyor?
- Kalibrasyon. “%90 eminim” dediğinde uzun vadede gerçekten buna yakın oranda doğru çıkıyor mu?
- Gecikme. Kararı kaç milisaniyede verebiliyor ve bu süre gerçek zamanlı akışa uygun mu?
- Karar başına maliyet. Tek bir sınıflandırma, yönlendirme veya risk kararı sisteme ne kadar maliyet ekliyor?
- Yüksek hacimde kapasite. Aynı sistem saniyede veya eşzamanlı olarak kaç kararı kaldırabiliyor?
- Düşük güvende doğru yönlendirme. Emin olmadığı yerde yanlış bir otomasyon çalıştırmak yerine geri çekilip başka modele veya insana yönlendirebiliyor mu?
Eğer bu model ailesi kalıcı olursa klasik LLM tablolarındaki “hangi model daha zeki?” sorusundan farklı ölçüler daha anlamlı hâle gelecek. Çünkü burada yarışın konusu paragraf kalitesi değil, karar kalitesi ve karar ekonomisi.
Her işi düşündürmek gerekmeyebilir
Jev’i ilginç yapan şey, büyük dil modellerine karşı bir “küçük model” olması değil. Tam tersine, büyük modellerin açtığı yolu başka bir yere götürmesi. BERT, GPT-3 ve talimat izleyen modeller doğal dildeki karmaşık bağlamı makinenin anlayabileceği bir problem hâline getirdi. Jev’in tezi, bu anlayışın her seferinde insan için paragraf üreten bir modele dönüşmek zorunda olmadığı.
Bu yüzden asıl soru “hangi model daha zeki?” değil. Yazılımın o anda neye ihtiyacı olduğu.
Temel çıkarım
Bu yazılım adımının çıktısı gerçekten ne olmalı?
- Kural kesin biçimde yazılabiliyorsa klasik kod yeterli olabilir.
- Görev doğal dili anlamayı gerektiriyor ama çıktı sınırlı bir karar ise refleks modeli tipi bir bileşen anlamlı olabilir.
- Görev açık uçlu üretim, araştırma, planlama veya uzun muhakeme gerektiriyorsa genel amaçlı bir LLM başka bir işi çözüyor demektir.
- Kararın sonucu ağırsa veya güven yetersizse insan denetimi ayrı bir güvenlik katmanıdır; “daha büyük model” ile aynı şey değildir.
Yapay zekâ otomasyonunun bir sonraki aşaması her problemi daha uzun düşündürmek olmayabilir. Bazı karmaşık kararları, bir kez makinenin anlayabildiği probleme dönüştürdükten sonra, düşünmeye ihtiyaç bırakmayacak kadar iyi sınırlamak olabilir.
Refleks benzetmesinin işe yaradığı yer de tam burası: amaç beynin daha kötü bir kopyasını yapmak değil; beynin devreye girmesine gerek olmayan anları ayırmak.
Kaynaklar
- Jev duyurusu ve model dokümantasyonu — üreticinin çalışma biçimi, fiyatlama ve mimari iddiaları.
- Foundation-model tarihçesi için: BERT, GPT-3 ve InstructGPT.
- Önceki yaklaşımlar için: Structured Outputs ve RouteLLM.
- Rafe & Das — Calibrated Decisions at Scale — Jev üzerinde bağımsız uygulama ve kalibrasyon verileri.
- Laya Typed-Decisions — benzer açık ağırlıklı yaklaşım.
- TechCrunch, 18 Eylül 2026 — kurucu geçmişi ve sentetik veri açıklaması.

2008’den bu yana web, yazılım ve dijital sistemlerle çalışıyor. Bugün yapay zekâ, otomasyon ve yeni teknolojilerin şirketleri, çalışma biçimlerini ve insanın rolünü nasıl değiştirdiği üzerine araştırma, danışmanlık ve uygulama yürütüyor.
Yeni yazılardan haberdar olun.
Yeni bir yazı yayımlandığında ChatGPT ile takip edin veya RSS akışını kullanın.